

GeMEB: Generative Models Empowering Businesses. ID progetto: 11277
L’Area Software Engineering ha realizzato due progetti R&I co-finanziati da BI-REX (Big Data Innovation and Research Excellence): GeMEB e SCAI.
OBIETTIVI.
Il progetto GeMEB (Generative Models Empowering Businesses) si basa su un framework per la consultazione di normative che sfrutti al meglio le potenzialità dei modelli linguistici generativi e le più recenti tecniche di Natural Language Processing (NLP). Lo scopo è quello di fornire uno strumento utile che faciliti, velocizzi e supporti la consultazione delle normative tecniche vigenti.
Di solito, le normative possono essere molto lunghe e complesse. Spesso sono piene di tabelle, grafici, immagini, e il linguaggio altamente specializzato. Queste caratteristiche rendono la consultazione un compito time-consuming anche per utenti molto esperti.
Dalle difficoltà che si incontrano ogni giorno nella consultazione delle normative nasce GeMEB.
Siamo partiti da una piccola serie di norme vigenti in ambito ferroviario, come le CENELEC e le UNISIG, che vista la loro importanza nell’ambito dei prodotti safety-critical e la loro complessità. Loro sono un esempio molto significativo delle difficoltà che caratterizzano questo problema e ci hanno permesso di ottenere un framework molto più robusto e generalizzabile.
La parte centrale del framework è l’attività di ricerca nelle informazioni nel testo che parte da una domanda posta dall’utente attraverso delle tecniche di “information retrieval” tipiche del mondo NLP. Poi, queste informazioni vengono “pulite” e categorizzate in modo che solo quelle più pertinenti alla domanda vengano usate come input di un modello linguistico generativo, il cui compito sarà “assemblarle” al meglio per fornire una risposta corretta e quanto più possibile simile a quella di una persona.
Il framework è stato implementato in modo da garantire la massima trasparenza di utilizzo e la privacy dei dati forniti dall’utente. Nello specifico, per ogni risposta ricevuta, l’utente ha la possibilità di visualizzare le parti del testo usate per generarla e quindi valutarne l’affidabilità. Le informazioni contenute nelle domande, invece, vengono scambiate su interfacce sicure e su una rete locale, dove viene utilizzato per il continuo miglioramento del framework senza alimentare risorse di terze parti come accade in molte soluzioni presenti on-line.
Nel proseguo della lettura puoi approfondire dagli aspetti tecnici agli sviluppi futuri.
IMPLEMENTAZIONE E RISULTATI.
L’implementazione del framework è strutturata su più fasi e prevede una stretta collaborazione tra i designer e gli utilizzatori finali. Il contributo di quest’ultimi, infatti, è stato fondamentale per la fase di selezione del modello linguistico, per l’annotazione di un dataset di addestramento e nella valutazione finale delle performance.
Il modello linguistico scelto è Zephyr-7B beta, che è rilasciato con licenza open-source, ha garantito la possibilità di addestrarlo ulteriormente insieme alla completa gestione del flusso dei dati. Il motivo? Concede la possibilità di installarlo in una workstation in locale.
Le normative scelte le abbiamo processate con una libreria Python chiamata Unstructured e che permette di estrarre da file di vari formati sia il testo sia le tabelle. I testi e le tabelle estratte sono state divise in pezzi più piccoli chiamati chunk e sono stati salvati in un database dedicato. La ricerca in questo database è stata implementata combinando la precisione della ricerca per parole chiave con la potenza della ricerca semantica.
L’addestramento del generative models, detto fine-tuning, è diviso in due parti. La prima prevede come input un dataset creato artificialmente con l’utilizzo di un altro modello linguistico un po’ più grande (Qwen-14B). Lo scopo di questa parte sta nel far imparare al modello linguistico il linguaggio altamente specializzato tipico delle normative tecnico-ferroviarie. La seconda parte, invece, conta un addestramento con un dataset annotato dagli utilizzatori finali. L’idea di questa fase ha il compito di allineare al meglio il modello alle richieste degli utilizzatori finali. Per facilitare la creazione di questo dataset annotato abbiamo implementato un tool apposito chiamato GeDI (GeMEB Data Input) che ha permesso di ottenere un dataset piccolo, ma accurato in un tempo breve e standard. Questo tool è indipendente dalla normativa da annotare e può essere usato direttamente anche per altri progetti.
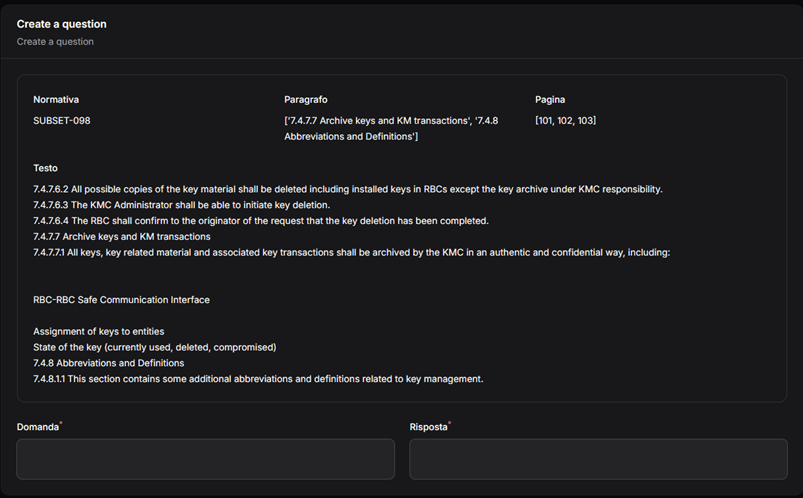
Figura 1 – Esempio di annotazione con GeDI
Dopo l’addestramento, abbiamo messo il generative models in comunicazione con i database creati in precedenza. Inoltre, per facilitarne l’utilizzo, abbiamo creato un’interfaccia grafica molto semplice da utilizzare. Infatti, l’utente può selezionare la normativa da interrogare, porre delle domande, e valutare le risposte ricevute in modo da avere un feedback aggiornato e un monitoraggio continuo.
Infine, prima di essere messo in servizio, il framework è stato valutato dai dipendenti di MeXage ed è stato modificato in base ai loro commenti e osservazioni.
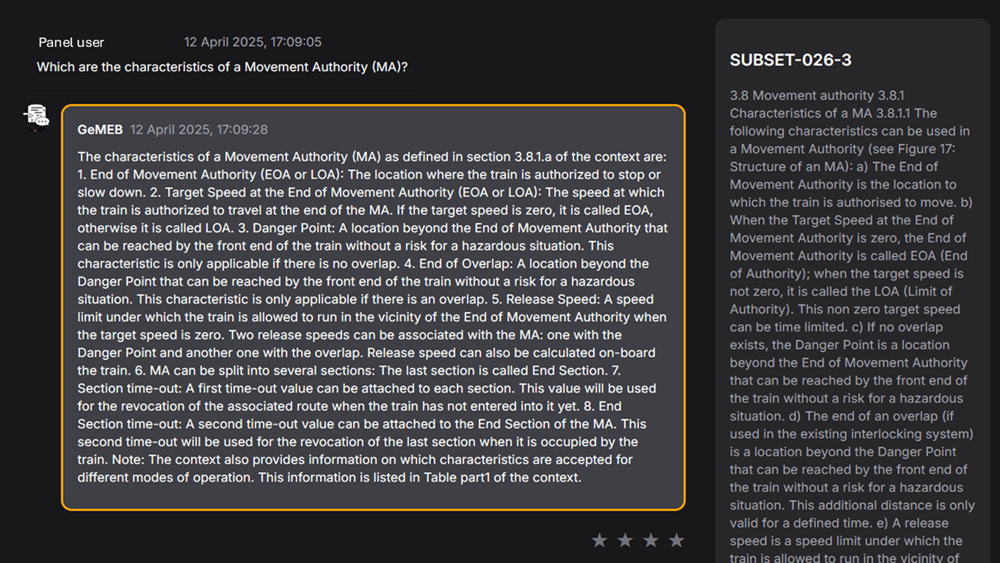
Figura 2 – Esempio di interazione con il framework
PARTNERSHIP E FINANZIAMENTO.
Questo progetto di generative models è co-finanziato dall’Unione Europea nell’ambito del piano NextGenerationEU per un valore di circa 230 mila euro su un totale di 590 mila euro. NIER è la capofila del progetto e fornirà tutte le sue conoscenze innovative in ambito ferroviario e software.
Inoltre, si avvarrà delle competenze e delle risorse di BI-REX, uno degli otto competence center in Italia focalizzato sui Big Data. Gli altri partner di progetto sono il gruppo di intelligenza artificiale (IA) del Dipartimento di Informatica – Scienza e Ingegneria (DISI) dell’Università degli Studi di Bologna e MeXage s.r.l..
Il compito dei primi sarà quello di incorporare nel progetto le conoscenze in materia di NLP e IA, ma anche le ultime novità della comunità scientifica di settore. Il compito della seconda, invece, sarà quello di utilizzare le loro competenze di sviluppo software in ambito ferroviario per testare le capacità del framework nella fase finale del progetto. Non solo, valuterà i punti di forza, quelli deboli e fornirà feedback per il miglioramento.
GENERATIVE MODELS: SVILUPPI FUTURI.
Tra gli sviluppi futuri, oltre al continuo aggiornamento del framework, c’è la sua applicazione a normative in altri ambiti come:
- Trasporto di sostanze pericolose (ad es. ADR)
- Gestione dei grandi rischi (D.lgs. 105/2015)
- Classificazione delle sostanze pericolose (ad es. REACH)
- Tutela ambientale (D.lgs. 152/2006).
L’utilità di GeMEB è diventata trasversale in molti ambiti tecnici.
ID progetto: 11277